- Wir haben in unserem Labor einen Server mit 8× NVIDIA A100 (HPE Apollo 6500) drei Tage lang mit zwei aktuellen Open-Source-Sprachmodellen vermessen — echte Messwerte, kein Datenblatt.
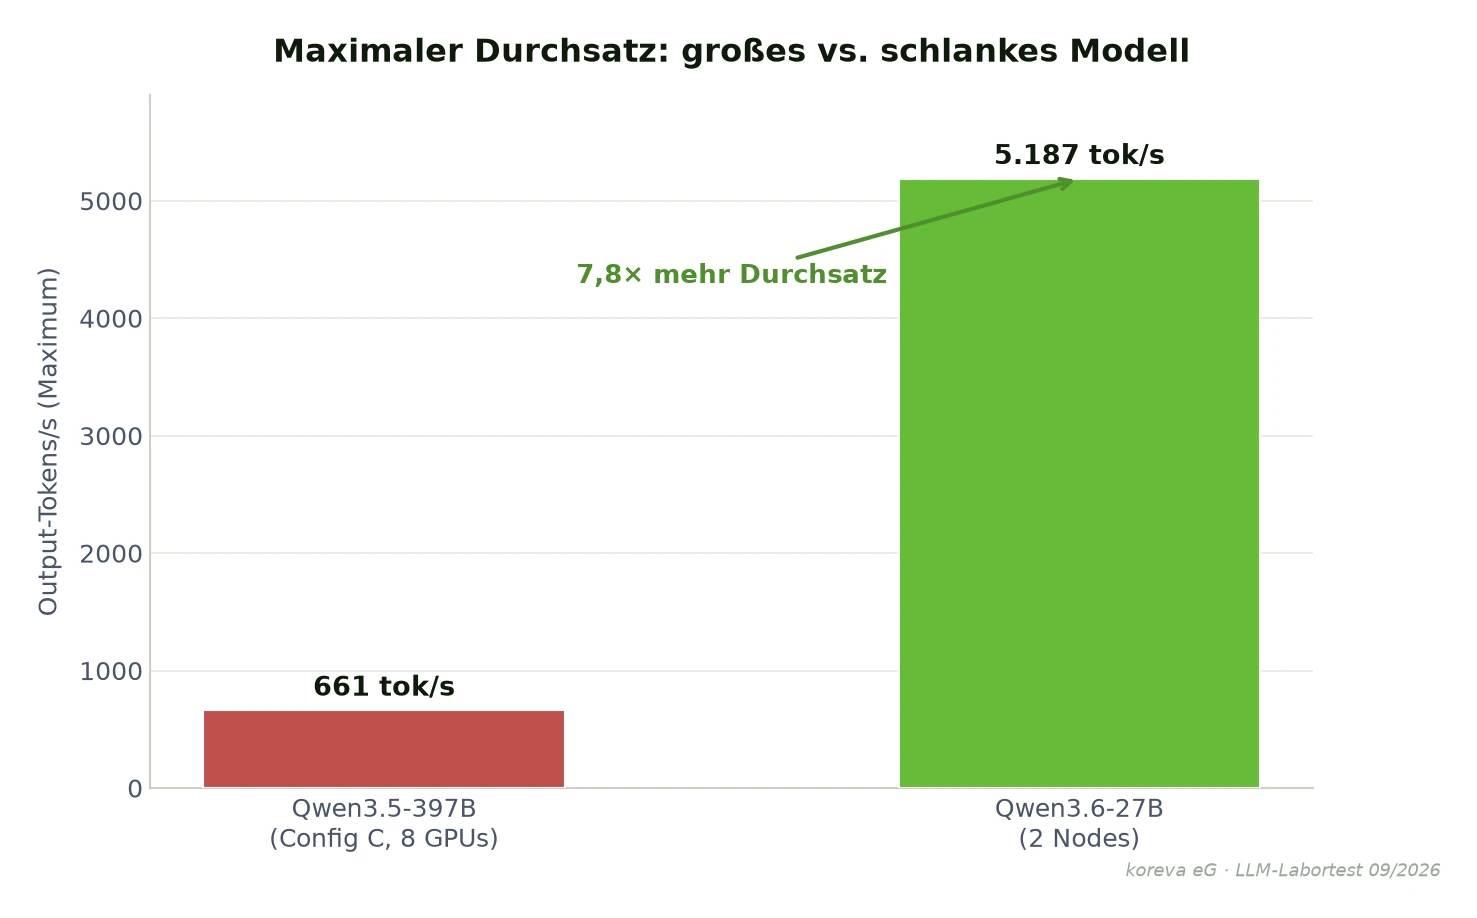
- Das große 397B-Modell liefert Spitzenqualität für rund 40 gleichzeitige Nutzer. Ein schlankes 27B-Modell schafft auf derselben Hardware das rund Achtfache an Durchsatz und etwa 250 Nutzer.
- Kernlehre: Modellgröße ist kein Qualitätsmaß. Für Durchsatz und Coding schlägt das kleine Modell das große.
- Der größte Hebel war die Software, nicht die Hardware: der richtige Rechen-Kernel plus Speculative Decoding brachten Faktor 2 bis 4.
- Ein Einzelnutzer sieht bis zu 109 Tokens/s bei ~1 s Wartezeit — schneller als viele Cloud-APIs, und die Daten bleiben im Haus.
Inhaltsverzeichnis
- Warum wir Hardware im eigenen Labor testen
- Der Prüfstand: 8× A100
- Was wir gemessen haben
- Das große Modell: Qualität für wenige Dutzend Nutzer
- Die Optimierungs-Story: Faktor 2–4 aus Software
- Das schlanke Modell: der Durchsatz-König
- Der direkte Vergleich
- Die ehrlichen Grenzen
- Was das für Ihr LLM-Projekt bedeutet
- Häufige Fragen
Warum wir Hardware im eigenen Labor testen
Datenblätter versprechen viel. Ob ein Server ein bestimmtes Sprachmodell tatsächlich flüssig und für genug Nutzer betreiben kann, steht dort nicht. Deshalb testen wir solche Fragen im eigenen Labor — mit echter Last, echten Modellen und echten Messwerten.
Für einen Kundenauftrag sollten wir klären, was ein gebrauchter Enterprise-Server mit acht NVIDIA-A100-GPUs bei aktuellen lokalen Sprachmodellen wirklich leistet: Wie viele Mitarbeiter können gleichzeitig damit arbeiten? Wie schnell antwortet das System? Und lohnt sich ein sehr großes Modell gegenüber einem kleineren? Als produktneutrale Genossenschaft empfehlen wir nichts, das wir nicht selbst gemessen haben — dieser Beitrag fasst die Ergebnisse zusammen.
Der Prüfstand: 8× A100
Das Testsystem war ein HPE Apollo 6500 Gen10 Plus aus zwei Rechenknoten mit insgesamt acht NVIDIA-A100-GPUs (40 GB, per NVLink und 100-Gbit-InfiniBand gekoppelt), rund einem Terabyte Arbeitsspeicher und schnellem NVMe-Speicher. Als Software-Stack lief vLLM in Docker unter Ubuntu 24.04.
- GPU: 8× NVIDIA A100-SXM4-40GB (320 GB GPU-Speicher gesamt), NVLink-Mesh
- Verbindung der Knoten: InfiniBand HDR100, 100 Gbit
- Host: AMD EPYC, ~500 GB RAM pro Knoten, NVMe-Modellspeicher
- Software: vLLM (OpenAI-kompatibel), Open WebUI als Oberfläche
Ein wichtiger Rahmen vorab: Die A100 gehört zur Ampere-Generation und beherrscht kein FP8 und keine neueren Hopper-Rechenkerne. Das begrenzt die sinnvoll betreibbaren Modelle nach oben — mehr dazu im Abschnitt „Grenzen“.
Was wir gemessen haben
Drei Kennzahlen entscheiden über das Nutzererlebnis eines LLM-Servers. Wir haben sie bei 1, 8, 32, 64 und 128 gleichzeitigen Anfragen gemessen:
- Durchsatz (Tokens/s): wie viele Wörter-Bausteine das Gesamtsystem pro Sekunde erzeugt — entscheidend für viele Nutzer gleichzeitig.
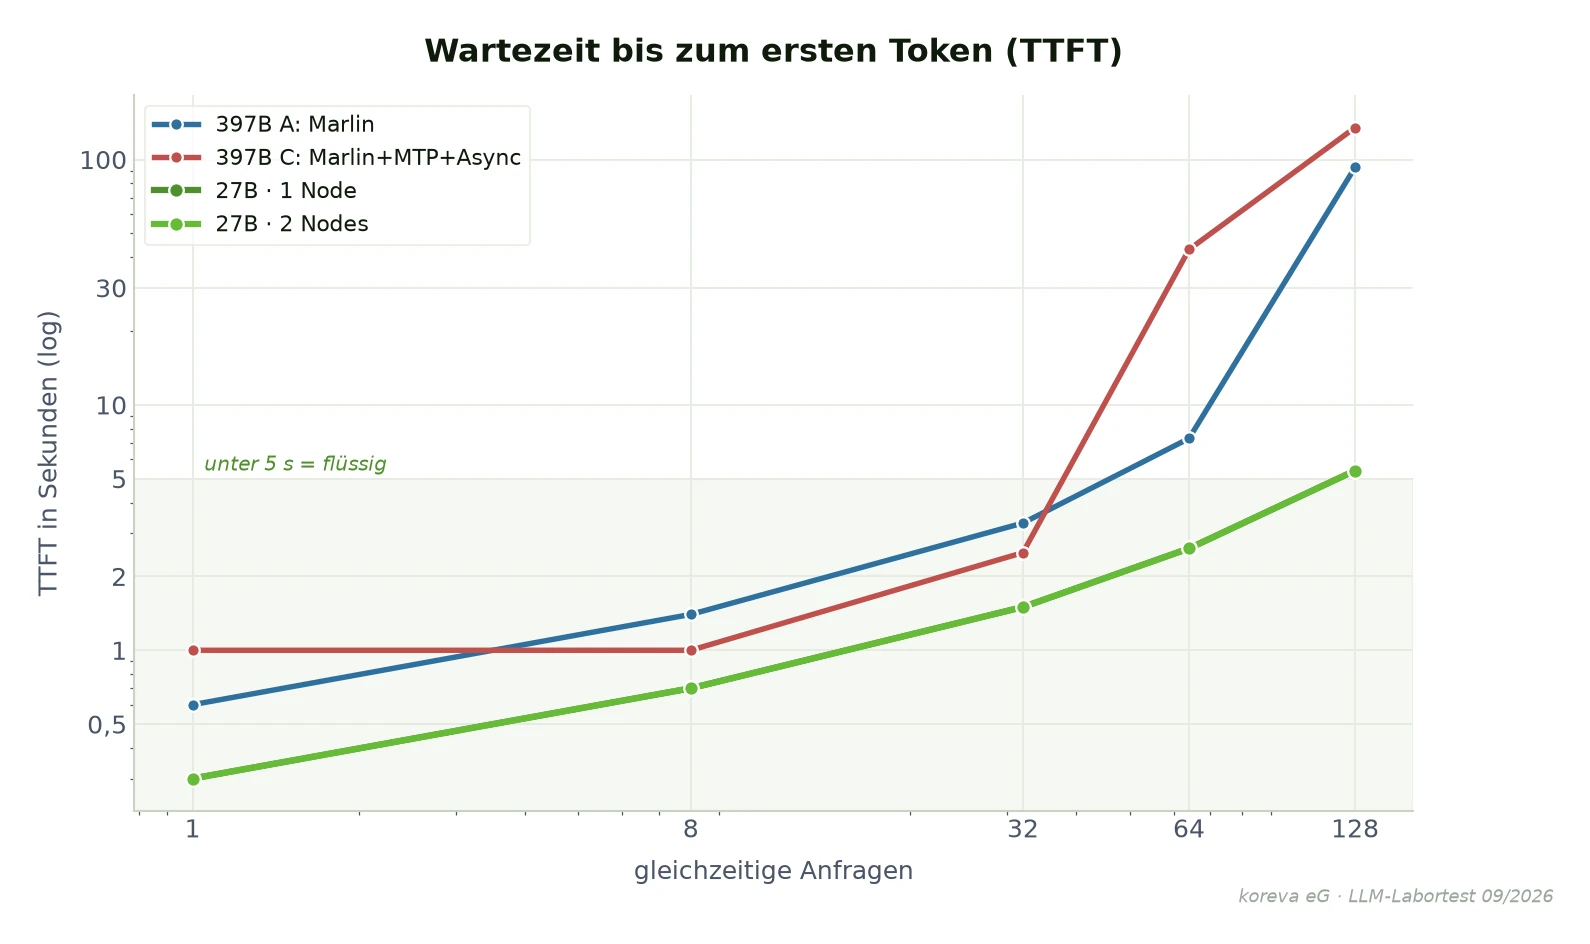
- Wartezeit / TTFT: die Zeit bis zum ersten Token, also wie lange ein Nutzer auf den Antwortbeginn wartet.
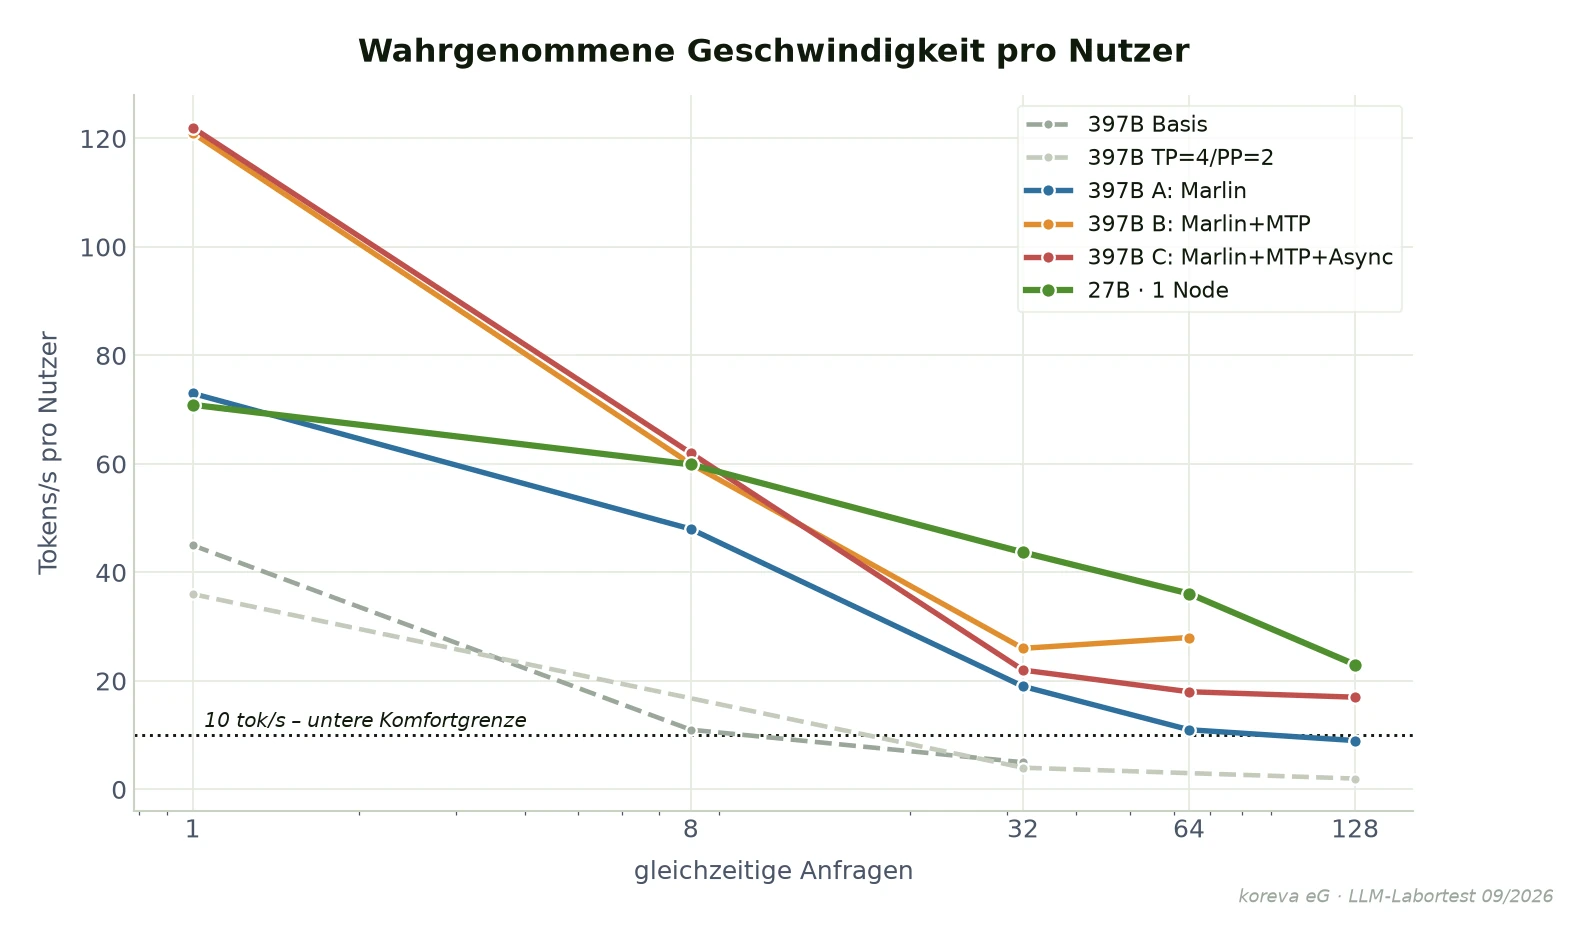
- Geschwindigkeit pro Nutzer: wie schnell die Antwort für den einzelnen Nutzer „läuft“. Ab etwa 10 Tokens/s liest es sich flüssig.
Das große Modell: Qualität für wenige Dutzend Nutzer
Das erste Modell war ein 397-Milliarden-Parameter-Modell (Mixture-of-Experts, mit Bildverständnis, quantisiert auf 4 Bit). Es belegt beide Rechenknoten und alle acht GPUs gleichzeitig. Ergebnis: ein exzellenter Qualitäts-Endpunkt — aber kein Massen-System.
- Einzelnutzer: bis 109 Tokens/s bei rund 1 Sekunde Wartezeit — schneller als viele Cloud-Dienste.
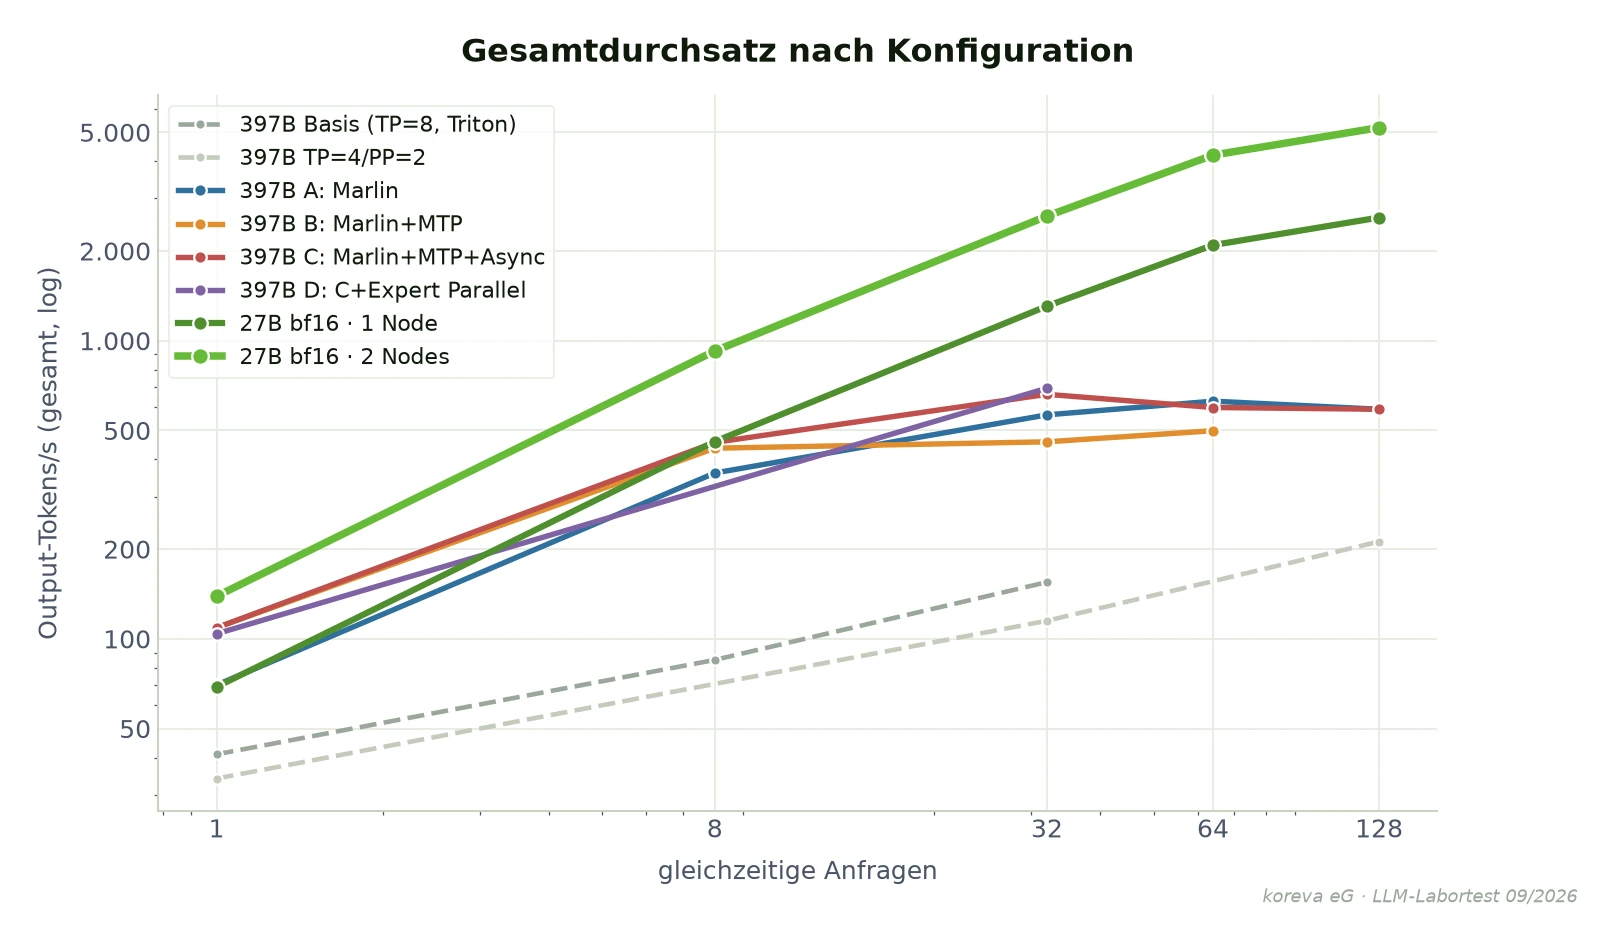
- Bester Gesamtdurchsatz: rund 660 Tokens/s bei etwa 32 gleichzeitigen Anfragen.
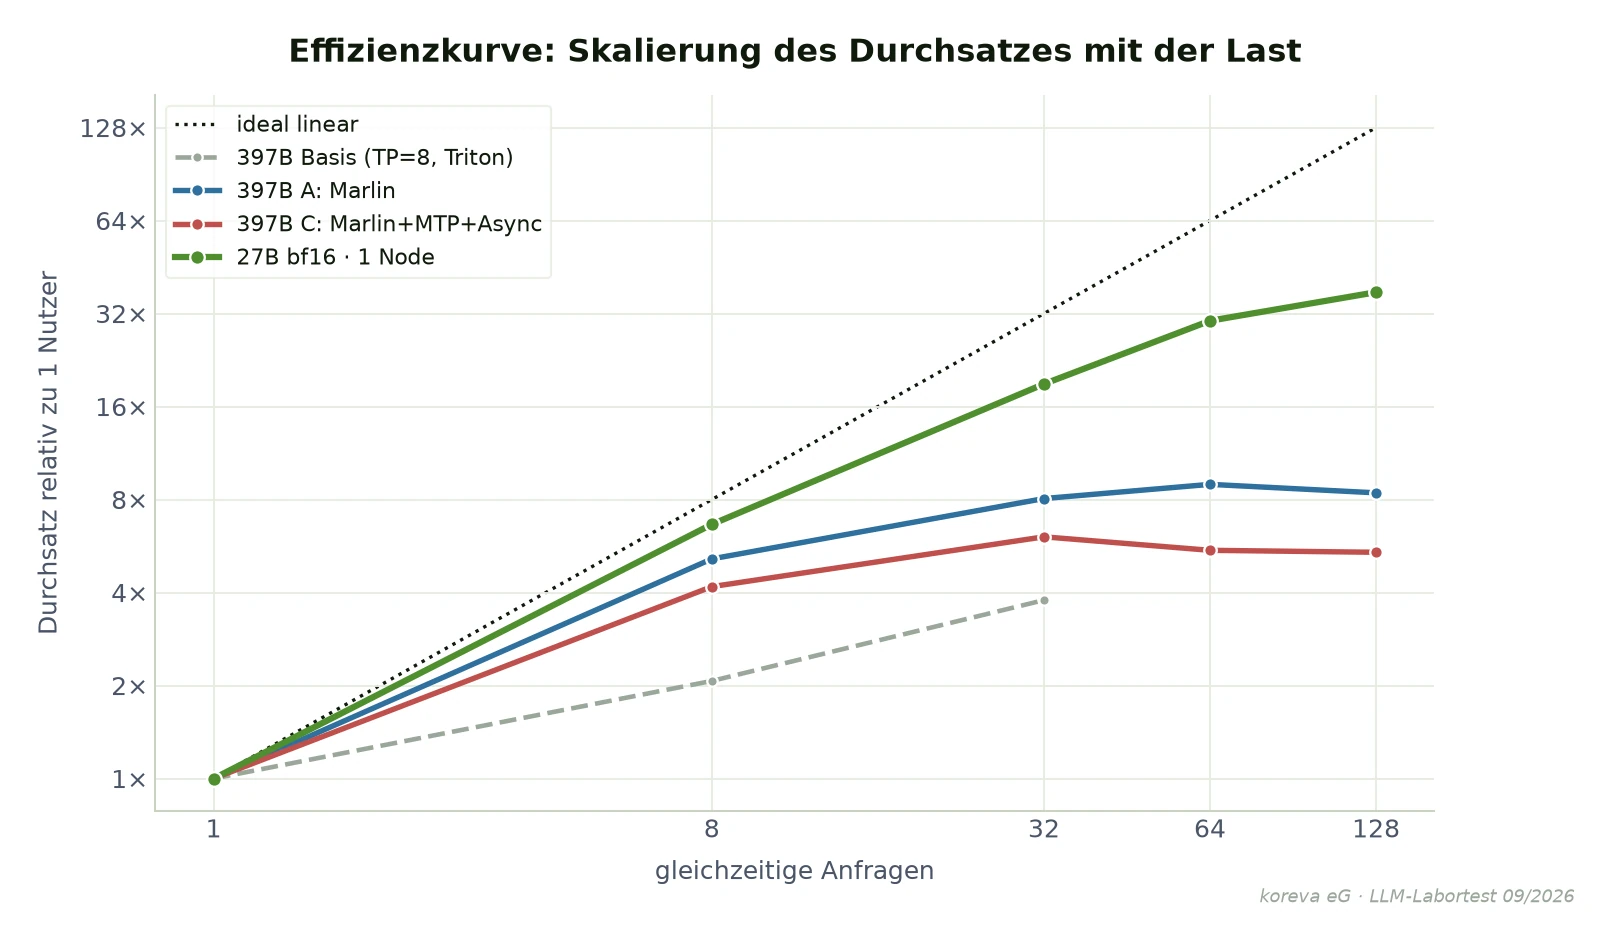
- Sinnvolle Obergrenze: rund 40 gleichzeitige Sessions. Darüber steigt die Wartezeit steil an, der Durchsatz stagniert.
Die Optimierungs-Story: Faktor 2–4 aus Software
Der spannendste Teil: Der größte Leistungssprung kam nicht aus schnellerer Hardware, sondern aus der richtigen Software-Konfiguration. Die Standard-Empfehlung aus dem offiziellen Rezept ist für neuere GPUs gedacht und war auf der A100 sogar kontraproduktiv.
Drei Stellschrauben brachten den Durchbruch:
- Der richtige Rechen-Kernel (Marlin statt Standard): Faktor 1,7 bis 4,2.
- Speculative Decoding (MTP): verdoppelt fast die Einzelnutzer-Geschwindigkeit (70 → 109 Tokens/s).
- Asynchrones Scheduling: hält die Warteschlange bis ~40 Sessions stabil und liefert den besten Gesamtwert.
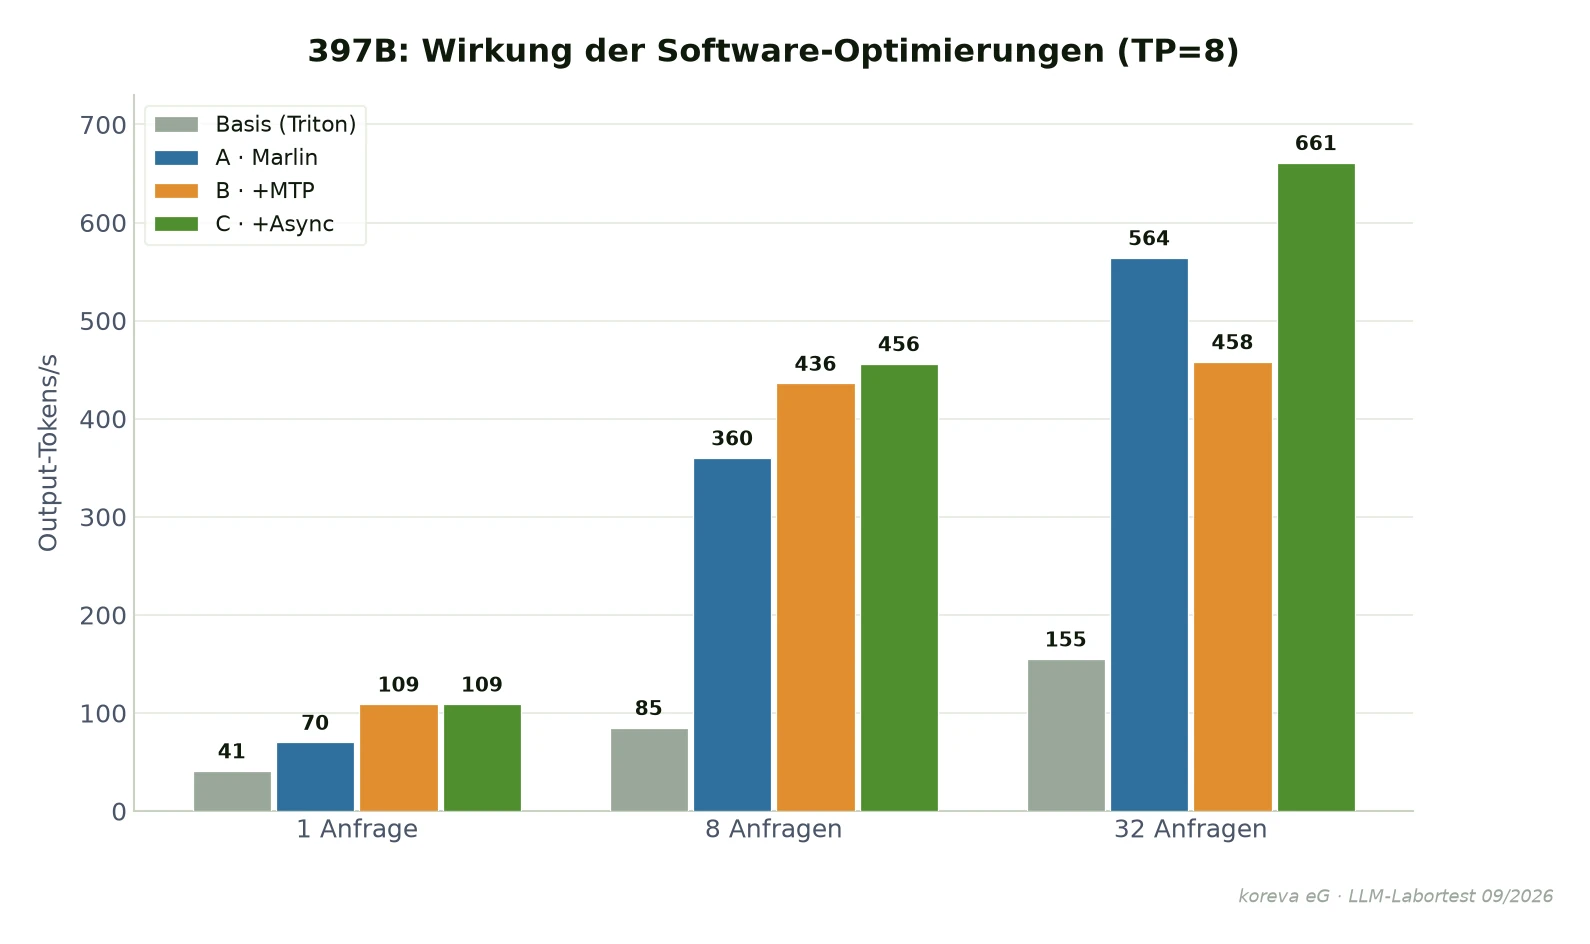
Die Lehre für Kundenprojekte: Wer einen LLM-Server nur „aufsetzt“, verschenkt schnell den Faktor 2 bis 4. Die Konfiguration ist die eigentliche Ingenieursleistung.
Das schlanke Modell: der Durchsatz-König
Das zweite Modell war ein 27-Milliarden-Parameter-Modell (dense, ohne Quantisierung). Es passt auf einen einzelnen Knoten — wir haben also beide Knoten als zwei unabhängige Endpunkte betrieben. Das Ergebnis war deutlich:
- Maximaler Durchsatz: 5.187 Tokens/s über beide Knoten — rund 8× mehr als das große Modell.
- Nutzbare Parallelität: rund 250 gleichzeitige Sessions.
- Skalierung nahezu linear über beide Knoten — keine gemeinsame Engstelle.
Der direkte Vergleich
| 397B (groß) | 27B (schlank) | |
|---|---|---|
| Max. Durchsatz | 661 Tokens/s | 5.187 Tokens/s |
| Nutzbare Parallelität | ~40 | ~250 |
| Einzelnutzer | 109 Tokens/s | 69 Tokens/s |
| Stärke | Weltwissen, Bild, mehrsprachig | Durchsatz, Coding |
| Betrieb | beide Knoten nötig, 15 Min Start | ein Knoten, 4 Min Start |
Die ehrlichen Grenzen
Zur produktneutralen Beratung gehört, auch die Grenzen zu benennen:
- Ampere ohne FP8: Auf der A100 ist ein 400B-MoE-Modell die obere sinnvolle Grenze. Größere oder neuere Architekturen brauchen Hopper- oder Blackwell-Karten (natives FP8, deutlich mehr Speicherbandbreite).
- Das große Modell ist kein Batch-System: Es glänzt als Qualitäts-Endpunkt für wenige Dutzend Nutzer, nicht für Massenverarbeitung.
- Betriebskomplexität: Multi-Node-Betrieb über InfiniBand ist anspruchsvoll; ein Einzelknoten-Setup mit dem 27B-Modell ist deutlich einfacher zu betreiben.
Was das für Ihr LLM-Projekt bedeutet
Die wichtigste Übertragung auf Kundenprojekte: Wählen Sie das Modell nach dem Anwendungsfall, nicht nach der Parameterzahl. Für einen internen Assistenten mit vielen Nutzern oder Coding-Unterstützung ist ein aktuelles schlankes Modell oft die bessere Wahl — schneller, günstiger, einfacher zu betreiben. Das sehr große Modell lohnt sich, wenn breites Weltwissen, Bildverständnis oder viele Sprachen gefragt sind.
Und: Die Hardware ist nur die halbe Miete. Der richtige Software-Stack entscheidet über Faktor 2 bis 4 — genau hier liegt der Unterschied zwischen „läuft“ und „läuft wirtschaftlich“. Wenn Sie wissen wollen, welche Hardware und welches Modell für Ihr Vorhaben reichen, testen wir das für Sie — bevor Sie investieren.